Sprzęt do lokalnego AI w 2026 roku: Jetson, Raspberry Pi, mini-PC czy GPU?
Praktyczny przewodnik z cenami: Jetson Orin Nano Super po podwyżce 399 USD, Raspberry Pi AI HAT+ 2 od 839 zł, mini-PC z NPU od 3000 zł. Kiedy co wybrać i dlaczego TOPS to nie jedyny parametr.
Materiały producenta NVIDIA, użycie redakcyjne. Zdjęcia produktowe w treści pochodzą z materiałów producentów.
Sprzęt do lokalnego AI nie jest jedną kategorią, i to jest pierwszy błąd przy wyborze. Inna platforma sprawdzi się przy kamerze wykrywającej osoby w magazynie, inna przy lokalnym chatbocie z dokumentami firmy, a jeszcze inna przy nauce modeli i eksperymentach. Kupowanie według hasła “dużo TOPS” zamiast według konkretnego zastosowania to najczęstszy błąd w tej kategorii.
Ten przewodnik zawiera ceny obserwowane 21 lipca 2026 i konkretne rekomendacje dla czterech głównych scenariuszy.
Kiedy lokalne AI ma sens?
Lokalne AI wygrywa gdy:
nie chcesz wysyłać danych do zewnętrznych serwerów (prywatność, regulacje),
potrzebujesz krótkiego opóźnienia, analiza obrazu z kamery w czasie rzeczywistym,
budujesz robota lub urządzenie autonomiczne bez stałego internetu,
masz dużo powtarzalnych zapytań i koszt API byłby istotny,
urządzenie ma działać w środowisku bez sieci.
Chmura wygrywa gdy:
chcesz najszybszej drogi do chatbota lub asystenta,
potrzebujesz największych modeli (GPT-4o, Claude Opus, Gemini Ultra), tych nie uruchomisz lokalnie,
nie chcesz konfigurować sterowników i środowiska,
projektujesz produkt, który musi skalować się do tysięcy użytkowników.
Ważny błąd: TOPS a praktyczna wydajność
Producenci podają TOPS (tera operations per second) jako główny parametr porównawczy. To myląca miara przy wielu zastosowaniach, bo:
Dedykowane NPU (neural processing unit) w Intel Core Ultra czy AMD Ryzen AI są zoptymalizowane pod konkretne typy modeli, przede wszystkim inference dla modeli sklasyfikowanych pod Windows AI i Copilot. Lokalne LLM-y uruchamiane przez Ollama lub LM Studio nie korzystają z tych NPU, działają na CPU i GPU.
TOPS bez podanej precyzji nic nie znaczy. Raspberry Pi AI HAT+ 2 ma na pudełku
40 TOPS, ale liczone przy INT4. Przy INT8, na której pracują modele wizyjne, ten sam
układ daje 20 TOPS, czyli nominalnie mniej niż 26 TOPS starszej AI HAT+. Raspberry Pi
deklaruje mimo to porównywalną wydajność wizyjną, bo liczy się architektura, a nie sama
liczba. Praktycy i tak radzą, żeby do samego widzenia zostać przy tańszych płytkach.
Sparse kontra dense. Jetson Orin Nano Super jest reklamowany jako 67 TOPS, co jest
wartością dla sieci z wymuszoną rzadkością wag. Dla zwykłych, gęstych modeli obowiązuje
33 TOPS. Producent podaje obie liczby, sklepy zwykle tylko wyższą.
TOPS z różnych architektur nie są porównywalne, bo akcelerator dla sieci
konwolucyjnych i jednostka NPU w procesorze mobilnym liczą to inaczej.
RAM jest ważniejszy niż TOPS przy modelach językowych. Same wagi w kwantyzacji 4-bit zajmują około 5 GB dla modelu 8B i około 8 GB dla 13B, ale do tego dochodzi pamięć na kontekst i bufory wykonawcze. Praktycznie planuj więc około 8 GB dla modelu 8B i 12-14 GB dla 13B, zależnie od długości kontekstu.
NVIDIA Jetson Orin Nano Super: edge AI i robotyka
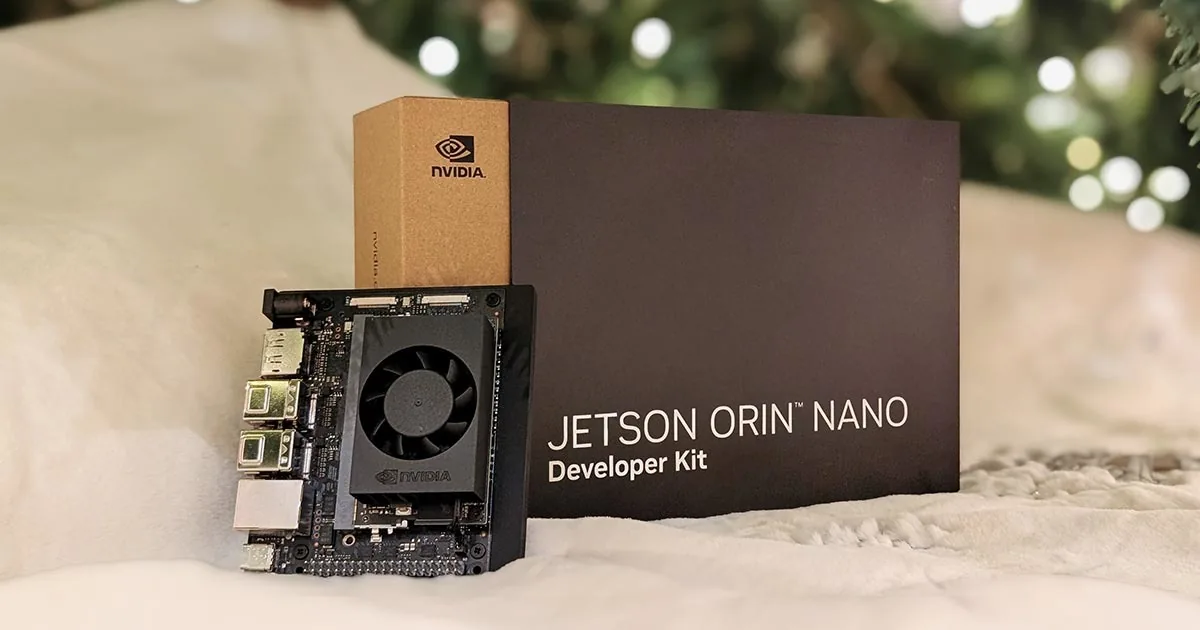
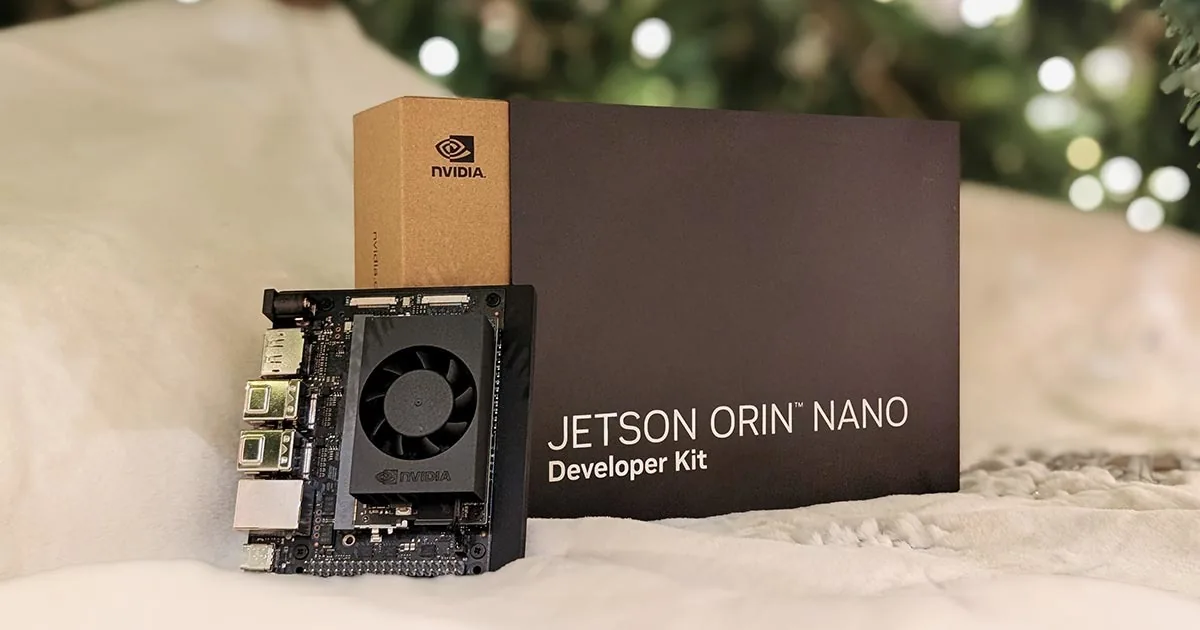
NVIDIA Jetson Orin Nano Super Developer Kit. Ta sama płytka co wcześniej, z nowym trybem zasilania i niższą ceną katalogową. Materiały producenta NVIDIA.
Jetson Orin Nano Super to aktualna propozycja NVIDIA dla segmentu embedded AI. Co ciekawe, nie jest to nowy sprzęt. Ta sama płytka co wcześniej dostaje nowy tryb zasilania podnoszący zegary, dzięki czemu wydajność rośnie z 40 do 67 TOPS sparse. Posiadacze starszych zestawów dostają ten tryb po aktualizacji JetPacka.
Uwaga o cenie, stan na 28 lipca 2026. Zestaw zadebiutował w grudniu 2024 za 249 dolarów, po obniżce z 499. W lipcu 2026 NVIDIA podniosła jednak ceny modułów i zestawów Jetson, a Orin Nano Super podrożał do 399 dolarów. Własna strona produktowa NVIDII w chwili sprawdzania nadal podawała 249 dolarów, więc przed zakupem sprawdź cenę u konkretnego sprzedawcy. W polskich sklepach zestaw bywał dostępny za około 1999 zł brutto, ale rozrzut ofert jest duży.
Specyfikacja:
CPU: 6× Arm Cortex-A78AE (1.7 GHz)
GPU: 1024 CUDA cores (Ampere)
AI: 67 TOPS sparse INT8, 33 TOPS dense INT8
RAM: 8 GB LPDDR5 (unified)
Interfejsy: 4× USB 3.2, PCIe, 2× MIPI CSI-2 (kamery)
Zasilanie: tryby modułu 15 W, 25 W i nielimitowany MAXN SUPER (przed wersją Super było 7 W i 15 W)
System: JetPack 7.2 na Ubuntu 24.04; uwaga, instalacja obrazem ISO potrafi odebrać tryb Super
Ceny (obserwacja z 21 lipca 2026):
cennik NVIDIA: 399 USD po podwyżce z lipca 2026, bez podatku
kamami.pl: 1999 zł brutto, czyli 1625,20 zł netto
Uwaga na tę różnicę, bo w zestawieniach cen krąży kwota około 1620 zł, która jest ceną
netto. Kupujący prywatnie płaci pełne 1999 zł, a odliczający VAT patrzy na kwotę netto.
Ekosystem: To największa przewaga Jetsona. NVIDIA JetPack SDK, pełna integracja CUDA, biblioteki do robotyki (ROS2, Isaac ROS), detekcja obiektów, pose estimation, computer vision, tysiące gotowych projektów i aktywna społeczność. Jeśli szukasz czegokolwiek do edge AI z kamerą lub robotem, znajdziesz przykłady dla Jetsona.
Dla kogo: Robotyka, kamery AI, urządzenia autonomiczne, edge inference dla modeli CV. Nie jest to sprzęt „plug and play”, wymaga Linuxa, konfiguracji środowiska, pracy z JetPack SDK.
Nie dla kogo: Lokalny chatbot i praca z dokumentami, tutaj mini-PC lub GPU sprawdzą się lepiej i taniej.
Raspberry Pi 5 + AI HAT+: dwa warianty
Raspberry Pi oferuje dwa rozwiązania AI jako nakładki HAT+ na Raspberry Pi 5. Używają akceleratorów Hailo i są dostępne w polskich sklepach. Dane obu wariantów zebraliśmy w karcie Raspberry Pi AI HAT+.
AI HAT+ (Gen 1, Hailo-8): detekcja obiektów i projekty edukacyjne
Dostępne w wersjach 13 TOPS i 26 TOPS. Nadaje się do:
detekcji i klasyfikacji obiektów z kamery,
projektów edukacyjnych i prototypów,
edge inference dla lekkich modeli.
Ceny:
13 TOPS: ok. $70 / ~350 zł (import)
26 TOPS: ok. $110 / €113,90 (botland.store, w magazynie)
Ograniczenia: Hailo-8 nie ma oficjalnego wsparcia dla generatywnych modeli językowych. Nie wynika to z tego, że obsługuje wyłącznie sieci konwolucyjne, bo radzi sobie też z częścią architektur transformerowych, na przykład Vision Transformer. Ogranicza go połączenie architektury układu, dostępnej pamięci i stosu programowego. Raspberry Pi 5 sam w sobie (bez HAT) uruchomi LLM przez Ollama, ale wolno, na CPU ARM.
AI HAT+ 2 (Gen 2, Hailo-10H): generatywne AI na Raspberry Pi
Wydany 15 stycznia 2026 roku. Kluczowa różnica: własne 8 GB pamięci LPDDR4X na płytce akceleratora, oddzielne od pamięci Raspberry Pi 5 i dla niego niewidoczne. To ta pamięć, a nie szybkość, jest sensem tego produktu.
Specyfikacja:
Akcelerator: Hailo-10H, 40 TOPS przy INT4 i 20 TOPS przy INT8
Pamięć: 8 GB LPDDR4X, własna i dedykowana
Pobór mocy układu: 2,5 W typowo
Interfejs: PCIe do Pi 5, zajmuje złącze przeznaczone też na dysk NVMe
Ceny (obserwacja z 21 lipca 2026):
karta produktu producenta: 200 USD (na premierze w styczniu 2026 było 130 USD)
kamami.pl: 839,07 zł brutto, dostępny od ręki
sprzedają też botland.com.pl, TME i DigiKey Polska, ceny się różnią
Co uruchomisz i czego się spodziewać: tu materiały się rozjeżdżają. Dokumentacja
producenta mówi o modelach do około 6 miliardów parametrów, a praktyczny test serwisu
Hackster o modelach do około 1,5 miliarda. Różnica jest czterokrotna. Recenzent
zaznacza przy tym, że modele tej wielkości to raczej ciekawostka niż narzędzie
do pracy. Traktuj tę płytkę jako sposób na naukę i prywatność, nie na tani zamiennik
asystenta z chmury.
Koszt całości (Pi 5 8GB + AI HAT+ 2): około 450 zł za Pi 5 plus od 839 zł
za nakładkę plus akcesoria, czyli mniej więcej od 1400 zł.
Dla kogo: Programiści i hobbbyści chcący uruchomić generatywne AI lokalnie w małym i energooszczędnym urządzeniu. Dobra platforma edukacyjna i startowa. Nie zastąpi pełnego komputera z GPU.
Mini-PC z NPU: lokalny LLM bez dedykowanego GPU
Mini-PC to kompromis między prostotą obsługi a wydajnością lokalnych modeli. W 2026 roku producenci aktywnie wypuszczają modele z oznaczeniem „AI PC”, procesory Intel Core Ultra (seria 1 i 2) oraz AMD Ryzen AI mają wbudowane NPU.
Ważna uwaga: NPU w tych procesorach przyspiesza głównie zadania Windows AI (np. Windows Studio Effects) i Copilot+. Narzędzia do lokalnych LLM. Ollama, LM Studio, Jan, nie korzystają z NPU i działają na CPU lub iGPU. Do efektywnego uruchamiania modeli 7B+ przez Ollama najważniejszy jest RAM (32+ GB) i czy model zmieści się w pamięci.
ASUS NUC 14 Pro AI: dostępny w Polsce, Intel Core Ultra Lunar Lake
Pierwszy na świecie mini-PC z Intel Core Ultra serii 2 (Lunar Lake), z wbudowanym NPU Intel AI Boost (~48 TOPS). Dostępny w oficjalnej dystrybucji ASUS Polska.
Procesor: Intel Core Ultra (seria 2, Lunar Lake)
NPU: ~48 TOPS
RAM: do 32 GB LPDDR5
Dostępność: oficjalna dystrybucja w Polsce, gwarancja PL
Dla Ollama/LLM: z 32 GB RAM sprawnie obsłuży modele do 13B w formacie 4-bit (np. Llama 3 8B, Mistral 7B, Phi-4). Większe modele będą wolne.
ASUS NUC 16 Pro: CES 2026, najnowszy
Ogłoszony w styczniu 2026 na CES, Intel Core Ultra X9 (Panther Lake). Dostępność i ceny w Polsce, do potwierdzenia.
Minisforum AI X1 Pro: AMD Ryzen AI 9 HX 370
Dostępny (lub był) na ceneo.pl w cenie ok. 7999 zł. Procesor AMD Ryzen AI 9 HX 370, 12 rdzeni/24 wątki, 5.1 GHz boost. Zintegrowany NPU Ryzen AI (~50 TOPS). Silny CPU dla Ollama.
Uwaga: Przy zakupie mini-PC z myślą o lokalnych LLM sprawdź przede wszystkim:
Maksymalną pojemność RAM (czy wspiera 32 lub 64 GB)
Czy ma slot NVMe dla modeli (duże modele, 10–40 GB pliki)
Pobór energii przy pełnym obciążeniu
Komputer z kartą graficzną GPU: najlepsza opcja do poważnych eksperymentów
Jeśli budujesz prototyp, uczysz się modeli lub regularnie testujesz różne architektury, komputer z dedykowaną kartą NVIDIA (CUDA) to najlepszy wybór. Karta graficzna z wystarczającą ilością VRAM pozwala uruchomić znacznie większe modele niż mini-PC.
Kluczowy parametr: VRAM
VRAM
Co uruchomisz lokalnie
8 GB
modele do 7B (4-bit), np. Llama 3 8B, Mistral 7B
12 GB
modele 7–13B swobodnie, pierwsze próby z 30B (4-bit)
16 GB
modele 13–30B (4-bit), Llama 3 70B wymaga offload
24 GB
modele 30–70B (4-bit) komfortowo
2× 24 GB
Llama 3 70B bez offload
Popularne karty do lokalnego AI (2026):
RTX 4060 (8 GB): budżetowy start
RTX 4060 Ti (16 GB): dobry stosunek VRAM do ceny
RTX 4070 / RTX 4070 Super (12 GB): popularny wybór
RTX 4080 Super / RTX 5070 (16 GB): duża wydajność, wyższy koszt
RTX 4090 (24 GB): maksimum VRAM w jednej karcie konsumenckiej
Dla kogo: Deweloperzy testujący modele, fine-tuning (wymaga jeszcze więcej VRAM), zaawansowane eksperymenty z vision AI i agentami, praca z modelami 30B+.
Chmura: kiedy warto zostać przy API
Chmura nie jest „gorszą” opcją. W kilku scenariuszach jest po prostu właściwą:
Chcesz najlepszej jakości: Claude Opus, GPT-4o, Gemini Ultra 1.5, tych modeli nie uruchomisz lokalnie.
Budżet jest ograniczony: $20/miesiąc za Claude Pro to mniej niż koszt karty GPU, jeśli używasz okazjonalnie.
Budujesz produkt dla użytkowników: API skaluje się automatycznie, nie dokupujesz serwerów.
Nie chcesz zarządzać infrastrukturą: modele, aktualizacje, bezpieczeństwo, to odpowiedzialność providera.
Kiedy API staje się drogie: przy bardzo dużej liczbie zapytań (> kilkaset tysięcy tokenów dziennie) koszty API mogą przekroczyć koszt utrzymania własnego serwera z modelem open-source.
Jak wybrać?
Masz projekt z kamerą lub robotem? → Tak: Jetson Orin Nano Super (399 USD po podwyżce, w Polsce od ok. 1999 zł brutto)To jest projekt edukacyjny lub mały prototyp edge AI? → Tak: Raspberry Pi 5 + AI HAT+ 2 (w Polsce od 839 zł) lub AI HAT+ 26 TOPS (~€113 / ~450 zł) dla CVChcesz lokalnego chatbota lub pracę z dokumentami? → Komputer z GPU (RTX 4060 Ti 16GB+) lub mini-PC z 32 GB RAM → Dla podstawowych modeli 7B: mini-PC ASUS NUC / Minisforum wystarczyChcesz eksperymentować z modelami 30B+? → Komputer z GPU RTX 4070 Super (12 GB) lub 4080 Super (16 GB)Chcesz gotowego produktu najwyższej jakości bez konfiguracji? → API (Claude, GPT-4o, Gemini)
Co sprawdzić przed zakupem
Zanim kupisz, znajdź przynajmniej jeden projekt podobny do twojego, na tym sprzęcie, z tym modelem. Jeśli nie ma przykładów, dokumentacji ani aktywnej społeczności, sama specyfikacja nie wystarczy.
Lista do sprawdzenia:
Jakie modele konkretnie uruchomisz, i czy mieszczą się w dostępnej pamięci?
Czy narzędzie, które chcesz użyć (Ollama, PyTorch, TensorFlow, ONNX), działa na tej platformie?
Jaki jest pobór energii przy pełnym obciążeniu?
Gdzie kupisz i jaka jest gwarancja (Polska / UE vs. import)?
Jakie są koszty akcesoriów (zasilanie, chłodzenie, SSD)?
Czy Raspberry Pi 5 uruchomi lokalny model językowy bez HAT?
Tak, przez Ollama lub llama.cpp na CPU. Modele 1–3B działają w praktyce. Llama 3 8B (4-bit) uruchomi się, ale odpowiedź zajmuje kilkadziesiąt sekund. Z AI HAT+ 2 i dedykowanymi 8 GB, realny throughput dla małych modeli.
Czy TOPS w mini-PC (np. 120 TOPS Intel Core Ultra) przyspiesza Ollama?
Nie bezpośrednio. Narzędzia do lokalnych LLM jak Ollama czy LM Studio działają przez CPU i GPU (iGPU lub dedykowane). NPU w Intel Core Ultra i AMD Ryzen AI jest zoptymalizowany pod Windows AI i Copilot+, nie pod narzędzia open-source. Kluczowy parametr dla Ollama to RAM i szybkość CPU.
Ile RAM potrzebuje mini-PC do lokalnego AI?
Minimum 16 GB dla modeli 7B w trybie 4-bit. 32 GB to wygodny start dla modeli 7–13B. Dla 30B+ modeli przez CPU, 64 GB.
Co to jest Ollama i jak zacząć?
Ollama to narzędzie umożliwiające uruchamianie open-source modeli językowych lokalnie (Windows, Mac, Linux). Po instalacji jedna komenda: ollama run llama3, i gotowe. Działa z Llama 3, Mistral, Phi, Qwen i wieloma innymi modelami.
Jetson Orin Nano Super vs Raspberry Pi 5 + AI HAT+ 2, co wybrać?
To są urządzenia do różnych celów, więc pytanie „który lepszy” nie ma sensu. Jetson daje ekosystem NVIDIA, czyli CUDA, ROS2 i Isaac, więc wygrywa wszędzie tam, gdzie jest kamera albo robot i gdzie rozwiązanie ma trafić do produkcji. Raspberry Pi z HAT+ 2 jest tańszy, prostszy w obsłudze i lepszy do nauki oraz eksperymentów z generatywnym AI na brzegu sieci. Krótko: robot albo kamera produkcyjna to Jetson, nauka i budżet to Raspberry Pi.
Czy warto kupić kartę GPU tylko do lokalnego AI?
Zależy od skali użycia. Przy codziennej pracy z modelami 7-13B karta RTX 4060 Ti z 16 GB pamięci za około 2000-2500 zł zwraca się w czasie i wygodzie szybciej niż comiesięczne opłaty za API. Przy użyciu okazjonalnym API jest tańsze i prostsze, bo nie płacisz za sprzęt stojący bezczynnie.
Skąd pochodzą te dane
Ceny pochodzą z cenników producentów i polskich sklepów, z datą obserwacji podaną przy każdej kwocie. Parametry techniczne pochodzą ze specyfikacji producentów, przy czym świadomie rozdzielamy liczby marketingowe od użytkowych, jak przy TOPS liczonych w różnych precyzjach. Nie prowadziliśmy własnych testów wydajności i nie podajemy wyników, których nie zmierzyliśmy.